هوش مصنوعی و یادگیری ماشین در سالهای اخیر به یکی از مهمترین ابزارهای تحلیل داده و تصمیمگیری تبدیل شدهاند. در میان روشهای مختلف یادگیری ماشین، یادگیری نظارتشده یکی از پایهایترین و پرکاربردترین روشها است که در پروژههای مختلف هوش مصنوعی به کار میرود. اما یادگیری نظارتشده دقیقاً چیست؟ چگونه کار میکند؟ و در چه پروژههایی میتوان از آن استفاده کرد؟ در این مقاله به بررسی این روش، کاربردهای آن و نکات مهمی که باید در استفاده از آن مدنظر قرار دهید، میپردازیم.
یادگیری نظارتشده چیست؟
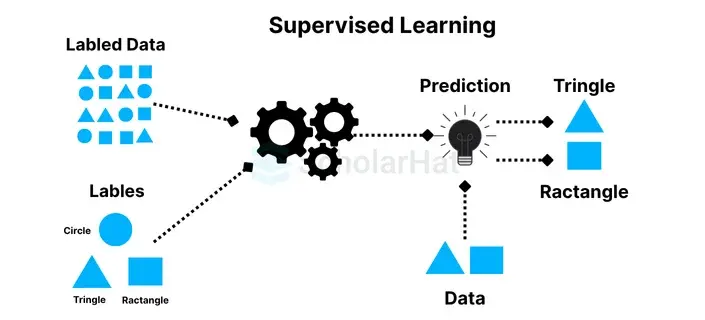
یادگیری نظارتشده (Supervised Learning) یکی از سه روش اصلی یادگیری ماشین است که در آن الگوریتمها با استفاده از دادههای برچسبدار (لبلدار) آموزش میبینند. این دادهها شامل ورودیها و خروجیهای مرتبط هستند که الگوریتم از طریق آنها میآموزد چگونه به ورودیهای جدید پاسخ صحیح بدهد. به عبارت دیگر، در یادگیری نظارتشده، الگوریتم با دادههایی که شامل پاسخهای صحیح هستند، آموزش میبیند و سپس میتواند بر اساس دادههای جدید پیشبینیهای دقیقی انجام دهد.
این روش به دلیل دقت بالا و کاربرد گسترده در پروژههای مختلف، یکی از محبوبترین روشهای یادگیری ماشین محسوب میشود. از تشخیص چهره گرفته تا پیشبینی قیمت سهام، یادگیری نظارتشده در بسیاری از حوزهها کاربرد دارد.
چگونه یادگیری نظارتشده کار میکند؟
فرآیند یادگیری نظارتشده شامل چند مرحله اصلی است:
- دادهبرداری و جمعآوری دادهها: دادههای لازم برای آموزش الگوریتم جمعآوری میشوند. این دادهها باید شامل ورودیها و خروجیهای مرتبط باشند.
- پاکسازی و آمادهسازی دادهها: دادهها ممکن است دارای خطا، دادههای ناقص یا غیرمنطقی باشند. در این مرحله، دادهها تمیز و آمادهسازی میشوند تا الگوریتم بتواند به بهترین شکل از آنها استفاده کند.
- تجزیه و تحلیل دادهها: دادهها تحلیل میشوند تا الگوریتم بتواند الگوهای مهم را شناسایی کند.
- آموزش الگوریتم: الگوریتم با استفاده از دادههای برچسبدار آموزش میبیند. این مرحله شامل انتخاب مدل مناسب و تنظیم پارامترهای آن است.
- ارزیابی و بهبود: پس از آموزش، الگوریتم با دادههای جدید تست میشود تا دقت آن ارزیابی شود. در صورت نیاز، پارامترهای الگوریتم تنظیم میشوند تا دقت بیشتری حاصل شود.
در این روش، الگوریتمها معمولاً با استفاده از تکنیکهای مختلفی مانند رگرسیون، درخت تصمیمگیری، ماشین بردار پشتیبان (SVM)، شبکههای عصبی و غیره آموزش میبینند.
کاربردهای یادگیری نظارتشده در پروژههای هوش مصنوعی
یادگیری نظارتشده در پروژههای مختلف هوش مصنوعی کاربردهای گستردهای دارد. برخی از مهمترین کاربردهای آن عبارتند از:
۱. تشخیص و طبقهبندی
یکی از کاربردهای اصلی یادگیری نظارتشده، تشخیص و طبقهبندی دادهها است. برای مثال:
- تشخیص اسپم ایمیل: الگوریتمها با استفاده از دادههای برچسبدار (ایمیلهای اسپم و غیر اسپم) آموزش میبینند تا بتوانند ایمیلهای جدید را به درستی طبقهبندی کنند.
- تشخیص سرطان: در پزشکی، الگوریتمهای یادگیری نظارتشده میتوانند با استفاده از تصاویر برچسبدار، تومورهای سرطانزا را تشخیص دهند.
- شناسایی چهره: سیستمهای شناسایی چهره مانند Face ID در گوشیهای هوشمند از یادگیری نظارتشده برای آموزش الگوریتمهای تشخیص استفاده میکنند.
۲. پیشبینی و پیشبینی زمانی
یادگیری نظارتشده در پیشبینیهای مختلف نیز بسیار مؤثر است:
- پیشبینی قیمت سهام: الگوریتمها میتوانند با استفاده از دادههای تاریخی قیمت سهام، پیشبینیهای دقیقی برای آینده ارائه دهند.
- پیشبینی آب و هوا: مدلهای هوش مصنوعی میتوانند با استفاده از دادههای تاریخی آب و هوایی، پیشبینیهای دقیقی برای روزهای آینده ارائه دهند.
- پیشبینی تقاضا: شرکتهای تجاری میتوانند با استفاده از یادگیری نظارتشده، تقاضا برای محصولات خود را پیشبینی کرده و برنامهریزی بهتری انجام دهند.
۳. تشخیص خطا و کنترل کیفیت
در صنایع مختلف، یادگیری نظارتشده برای تشخیص خطا و کنترل کیفیت محصولات استفاده میشود:
- کنترل کیفیت در خط تولید: الگوریتمها میتوانند با استفاده از دادههای برچسبدار، محصولات معیوب را شناسایی کنند.
- تشخیص خطا در سیستمهای خودکار: در سیستمهای خودکار مانند رباتیک، الگوریتمها میتوانند خطاهای احتمالی را پیشبینی و تشخیص دهند.
نکات مهم در استفاده از یادگیری نظارتشده
اگر قصد استفاده از یادگیری نظارتشده در پروژههای خود را دارید، باید به چند نکته مهم توجه کنید:
۱. کیفیت دادهها
کیفیت دادهها یکی از مهمترین عوامل در موفقیت یک پروژه یادگیری نظارتشده است. دادههای ناقص، نامناسب یا دارای خطا میتوانند منجر به نتایج نادرست شوند. بنابراین، باید به پاکسازی، آمادهسازی و انتخاب دادههای مناسب توجه ویژهای داشته باشید.
۲. انتخاب الگوریتم مناسب
هر الگوریتم یادگیری نظارتشده برای نوع خاصی از دادهها و مشکلات طراحی شده است. برای مثال:
- در مشکلاتی که نیاز به طبقهبندی دودویی یا چندگانه دارند، الگوریتمهای درخت تصمیمگیری، رگرسیون لجستیک یا شبکههای عصبی میتوانند مناسب باشند.
- در مشکلات پیشبینی پیوسته، الگوریتمهای رگرسیون مانند رگرسیون خطی یا رگرسیون چندگانه مناسبتر هستند.
انتخاب الگوریتم مناسب به تجربه و دانش شما در زمینه یادگیری ماشین بستگی دارد. در صورت نیاز، میتوانید از کتابخانههای مختلف مانند Scikit-learn برای تست الگوریتمهای مختلف استفاده کنید.
۳. تقسیم دادهها به مجموعههای آموزش و تست
برای ارزیابی دقت الگوریتم، باید دادهها را به دو مجموعه آموزش و تست تقسیم کنید. مجموعه آموزش برای آموزش الگوریتم و مجموعه تست برای ارزیابی دقت آن استفاده میشود. معمولاً ۷۰ تا ۸۰ درصد دادهها برای آموزش و ۲۰ تا ۳۰ درصد برای تست استفاده میشوند.
۴. تنظیم پارامترها (Hyperparameter Tuning)
تنظیم پارامترهای الگوریتم میتواند تأثیر زیادی بر دقت آن داشته باشد. برای مثال، در الگوریتمهای درخت تصمیمگیری، عمق درخت، تعداد برگها و سایر پارامترها میتوانند بر عملکرد الگوریتم تأثیر بگذارند. استفاده از تکنیکهای مختلفی مانند Grid Search یا Random Search میتواند در تنظیم پارامترها کمککننده باشد.
۵. ارزیابی مدل
پس از آموزش الگوریتم، باید مدل را با استفاده از متریکهای مناسب ارزیابی کنید. برخی از متریکهای رایج عبارتند از:
- دقت (Accuracy): درصد پیشبینیهای صحیح.
- دقت (Precision) و حساسیت (Recall): برای مشکلات طبقهبندی.
- خطای میانگین مربعی (MSE) و خطای مطلق میانگین (MAE): برای مشکلات پیشبینی پیوسته.
انتخاب متریک مناسب به نوع مشکل و دادهها بستگی دارد.
چالشهای یادگیری نظارتشده
در حالی که یادگیری نظارتشده مزایای بسیاری دارد، اما با چالشهایی نیز همراه است:
- نیاز به دادههای برچسبدار: یکی از بزرگترین چالشها نیاز به دادههای برچسبدار است. برچسبگذاری دادهها زمانبر و گاهی هزینهبر است.
- عمومپذیری: الگوریتمهای آموزش دیده ممکن است در شرایط جدید و دادههای جدید عملکرد خوبی نداشته باشند.
- بias و Variance: الگوریتمها ممکن است دچار bias (خطا سیستماتیک) یا Variance (حساسیت بیش از حد به دادههای آموزش) شوند.
برای مقابله با این چالشها، میتوانید از تکنیکهای مختلفی مانند افزایش دادهها، استفاده از دادههای مصنوعی یا روشهای کاهش ابعاد استفاده کنید.
یادگیری نظارتشده در مقابل سایر روشهای یادگیری ماشین
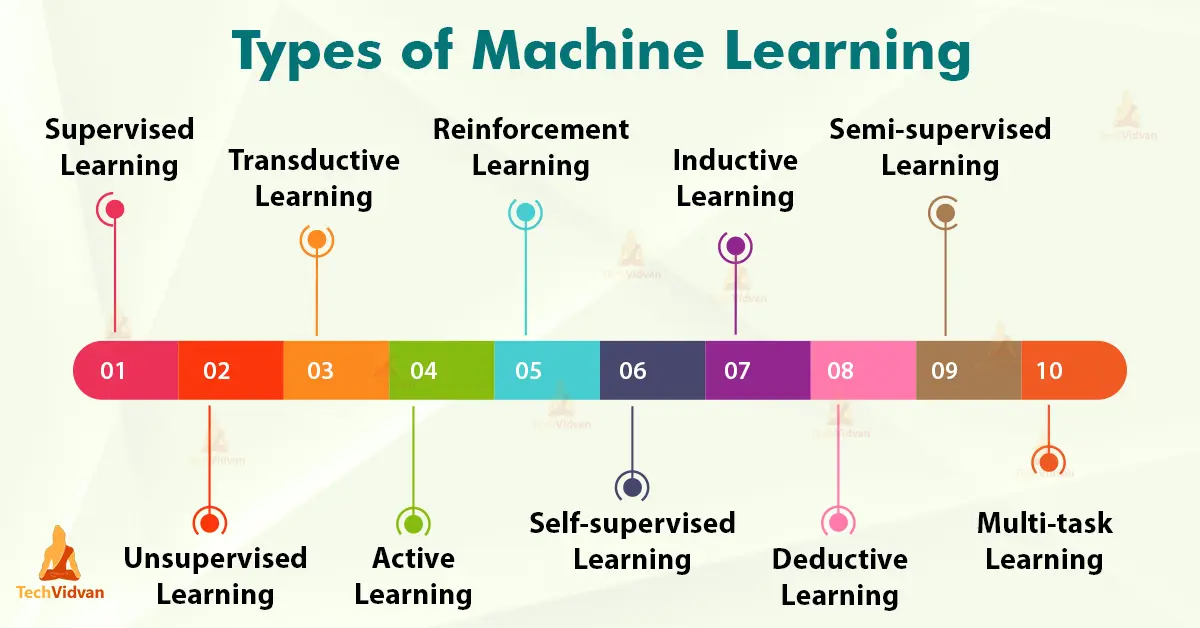
یادگیری نظارتشده تنها یکی از سه روش اصلی یادگیری ماشین است. دو روش دیگر عبارتند از:
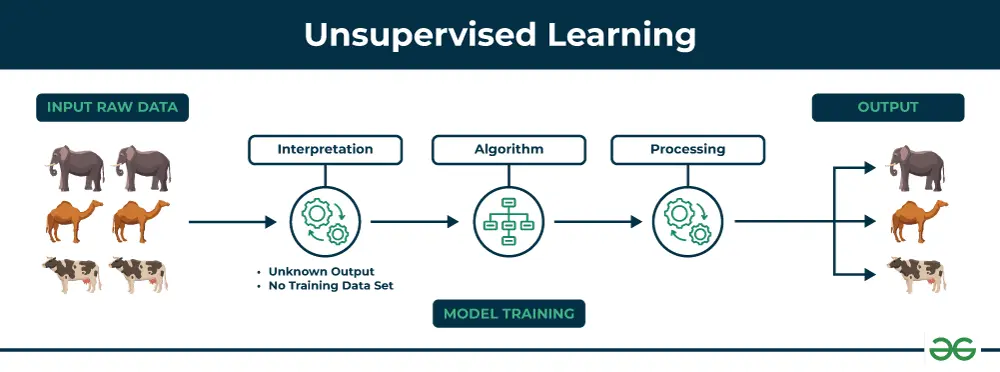
- یادگیری بدون نظارت (Unsupervised Learning): در این روش، الگوریتمها بدون استفاده از دادههای برچسبدار آموزش میبینند و سعی میکنند الگوهای پنهان در دادهها را شناسایی کنند. این روش برای خوشهبندی و کاهش ابعاد دادهها استفاده میشود.
- یادگیری تقویتی (Reinforcement Learning): در این روش، الگوریتمها با استفاده از پاداش و تنبیه آموزش میبینند و سعی میکنند بهترین عملکرد را در یک محیط خاص کسب کنند. این روش در رباتیک و بازیهای ویدئویی کاربرد دارد.
هر یک از این روشها مزایا و معایب خاص خود را دارند و انتخاب روش مناسب به نوع مشکل و دادهها بستگی دارد.
اگر میخواهید در مورد روشهای مختلف یادگیری ماشین و کاربردهای آنها در پروژههای واقعی اطلاعات بیشتری کسب کنید، میتوانید به مقالات مرتبط در چجوره مراجعه کنید. این مقالات میتوانند راهنمایی ارزشمندی برای شروع پروژههای هوش مصنوعی با استفاده از یادگیری نظارتشده باشند.